
Ứng dụng học máy trong phân loại rủi ro tín dụng khách hàng cá nhân tại các ngân hàng thương mại Việt Nam
Tóm tắt: Nghiên cứu đánh giá khả năng ứng dụng các thuật toán học máy trong phân loại rủi ro tín dụng khách hàng cá nhân tại các NHTM Việt Nam. Nghiên cứu xây dựng mô hình phân loại đa lớp, xử lý mất cân bằng dữ liệu và so sánh hồi quy Logistic đa thức với các thuật toán Random Forest, XGBoost và LightGBM. Kết quả cho thấy các thuật toán học máy, đặc biệt là LightGBM có khả năng hỗ trợ phân loại và nhận diện các nhóm nợ có mức độ rủi ro khác nhau. Phân tích SHapley Additive exPlanations - SHAP (là một phương pháp giải thích mô hình học máy), đồng thời làm rõ vai trò của các yếu tố liên quan đến lịch sử tín dụng, đặc điểm khách hàng, nghĩa vụ trả nợ và mức độ ổn định của thông tin trong kết quả dự báo. Nghiên cứu khẳng định học máy có tiềm năng hỗ trợ thẩm định và cảnh báo sớm rủi ro tín dụng, nhưng cần được kết hợp với quy trình thẩm định và giám sát của ngân hàng.
Từ khóa: Học máy, thẩm định tín dụng, rủi ro tín dụng, khách hàng cá nhân.
 |
| Ảnh minh họa (Nguồn: https://bidv.com.vn/) |
1. Đặt vấn đề
Tín dụng bán lẻ đang trở thành một trong những động lực tăng trưởng quan trọng của các NHTM Việt Nam. Việc mở rộng cho vay khách hàng cá nhân góp phần đa dạng hóa nguồn thu, mở rộng thị phần và thúc đẩy phát triển các sản phẩm, dịch vụ tài chính bán lẻ. Tuy nhiên, cùng với sự gia tăng nhanh về quy mô tín dụng là áp lực ngày càng lớn đối với công tác thẩm định và quản trị rủi ro. Đặc điểm của phân khúc khách hàng cá nhân là số lượng khoản vay lớn, giá trị khoản vay nhỏ, thông tin tài chính không đồng nhất và hành vi trả nợ có thể thay đổi theo thời gian. Điều này đòi hỏi các NHTM phải nâng cao khả năng nhận diện sớm các khoản vay tiềm ẩn rủi ro ngay từ giai đoạn thẩm định.
Để đáp ứng yêu cầu đó, nhiều NHTM đã triển khai các mô hình chấm điểm tín dụng nhằm hỗ trợ đánh giá khách hàng và ra quyết định cấp tín dụng. Tuy nhiên, phần lớn các mô hình truyền thống được xây dựng trên các giả định tuyến tính hoặc hệ thống quy tắc chuyên gia. Khi quy mô và mức độ phức tạp của dữ liệu ngày càng gia tăng, các mô hình này có thể chưa khai thác đầy đủ các mối quan hệ phi tuyến, sự tương tác giữa các biến đầu vào cũng như các đặc trưng hành vi có giá trị dự báo rủi ro (Hand và Henley, 1997; Thomas và cộng sự, 2002; Crook và cộng sự, 2007). Vì vậy, việc nghiên cứu các phương pháp có khả năng nâng cao hiệu quả phân loại và cảnh báo sớm rủi ro tín dụng đang trở thành một yêu cầu cấp thiết đối với các NHTM. Yêu cầu này càng trở nên rõ nét trong bối cảnh các chuẩn mực và quy định về quản trị rủi ro tín dụng không ngừng được hoàn thiện. Chuẩn mực Báo cáo Tài chính Quốc tế số 9 (IFRS 9) chuyển từ mô hình ghi nhận tổn thất đã phát sinh sang mô hình tổn thất tín dụng kỳ vọng, trong đó việc lượng hóa xác suất phát sinh rủi ro đóng vai trò quan trọng trong đánh giá chất lượng tín dụng và trích lập dự phòng (IFRS Foundation, 2014).
Tại Việt Nam, quy định hiện hành của Ngân hàng Nhà nước Việt Nam (NHNN) về phân loại tài sản có và phân loại nợ cũng đặt ra yêu cầu nâng cao chất lượng đánh giá rủi ro, làm cơ sở cho quản trị danh mục tín dụng và kiểm soát nợ xấu. Trong bối cảnh đó, các công cụ có khả năng hỗ trợ phân loại khoản vay theo mức độ rủi ro không chỉ mang ý nghĩa về mặt kỹ thuật mà còn có giá trị thực tiễn đối với hoạt động quản trị của các NHTM.
Sự phát triển của học máy mở ra hướng tiếp cận mới cho bài toán này. Khác với các mô hình thống kê truyền thống, các thuật toán học máy có khả năng khai thác dữ liệu quy mô lớn, nhận diện các quan hệ phi tuyến và học từ những mẫu dữ liệu phức tạp mà không cần thiết lập trước dạng quan hệ giữa các biến (Mitchell, 1997). Nhiều nghiên cứu đã chứng minh các thuật toán như Random Forest, XGBoost và LightGBM đạt hiệu quả cao trong các bài toán chấm điểm tín dụng và phân loại rủi ro (Breiman, 2001; Lessmann và cộng sự, 2015; Chen và Guestrin, 2016; Ke và cộng sự, 2017). Tại Việt Nam, một số nghiên cứu đã sử dụng cây phân lớp và các thuật toán học máy trong dự báo nguy cơ kiệt quệ tài chính và rủi ro phá sản doanh nghiệp (Huỳnh Thị Cẩm Hà và cộng sự, 2017; Trương Thị Thùy và Lê Hải Trung, 2023). Tuy nhiên, bằng chứng thực nghiệm tại Việt Nam vẫn còn tương đối hạn chế, đặc biệt đối với các nghiên cứu so sánh một cách hệ thống giữa mô hình thống kê truyền thống và các thuật toán tổ hợp theo cơ chế đóng gói (Bagging) và tăng cường (Boosting) (kết hợp nhiều mô hình học cơ sở để cải thiện hiệu quả dự báo) trên dữ liệu tín dụng khách hàng cá nhân của NHTM. Bên cạnh đó, việc làm rõ khả năng ứng dụng các mô hình này trong bối cảnh phân loại nợ theo quy định hiện hành và hỗ trợ quy trình thẩm định tín dụng vẫn chưa được nghiên cứu đầy đủ.
Xuất phát từ khoảng trống trên, bài viết xây dựng và kiểm định khung phân loại đa lớp đối với các khoản vay của khách hàng cá nhân trên cơ sở dữ liệu thực nghiệm của một số NHTM Việt Nam. Nghiên cứu so sánh hiệu năng của bốn thuật toán gồm hồi quy Logistic đa thức, Random Forest, XGBoost và LightGBM trong điều kiện dữ liệu mất cân bằng. Đồng thời, phương pháp SHAP được sử dụng để giải thích mức đóng góp của các biến đầu vào đối với kết quả dự báo, qua đó nâng cao khả năng diễn giải của mô hình. Trên cơ sở kết quả thực nghiệm, bài viết đề xuất một số hàm ý nhằm hỗ trợ các NHTM ứng dụng học máy trong hoạt động thẩm định, cảnh báo sớm và quản trị rủi ro tín dụng.
2. Giả thuyết và mô hình nghiên cứu
2.1. Thuật toán tổ hợp và hiệu năng phân loại rủi ro tín dụng
Trong tín dụng bán lẻ, trạng thái của khoản vay chịu ảnh hưởng đồng thời bởi nhiều nhóm thông tin, bao gồm đặc điểm nhân khẩu học, lịch sử tín dụng, nghĩa vụ tài chính và mức độ ổn định của khách hàng. Mối quan hệ giữa các yếu tố này với rủi ro tín dụng không nhất thiết mang tính tuyến tính. Vì vậy, các mô hình thống kê truyền thống có thể chưa khai thác đầy đủ sự tương tác giữa các biến đầu vào và cấu trúc phức tạp của dữ liệu tín dụng (Hand và Henley, 1997; Crook và cộng sự, 2007).
Các nghiên cứu đối sánh cho thấy thuật toán tổ hợp có khả năng nâng cao hiệu năng phân loại trong bài toán chấm điểm tín dụng. Thuật toán Random Forest áp dụng cơ chế Bagging nhằm giảm phương sai thông qua việc tổng hợp kết quả của nhiều cây quyết định. Thuật toán XGBoost và LightGBM sử dụng cơ chế Boosting, trong đó các mô hình được xây dựng tuần tự để khắc phục sai số của các vòng lặp trước. Nhờ đó, nhóm thuật toán này có thể khai thác tốt hơn các quan hệ phi tuyến và tương tác giữa các biến so với mô hình tuyến tính trong một số bộ dữ liệu tín dụng (Breiman, 2001; Baesens và cộng sự, 2003; Lessmann và cộng sự, 2015).
Tuy nhiên, hiệu năng của mô hình còn phụ thuộc vào đặc điểm dữ liệu, mức độ mất cân bằng giữa các lớp, quy trình tiền xử lý và cách hiệu chỉnh siêu tham số. Do đó, không có cơ sở để khẳng định một thuật toán luôn vượt trội trong mọi trường hợp. Đối với dữ liệu tín dụng khách hàng cá nhân tại Việt Nam, bằng chứng thực nghiệm so sánh trực tiếp giữa hồi quy Logistic đa thức và các thuật toán tổ hợp vẫn còn hạn chế. Trên cơ sở đó, nghiên cứu đề xuất giả thuyết:
H1: Các thuật toán tổ hợp đạt hiệu năng phân loại đa lớp cao hơn hồi quy Logistic đa thức trên bộ dữ liệu nghiên cứu.
2.2. So sánh hiệu năng giữa XGBoost và LightGBM
XGBoost và LightGBM đều thuộc nhóm thuật toán tăng cường độ dốc, nhưng khác nhau về cơ chế xây dựng cây. XGBoost phát triển cây theo từng mức và sử dụng cơ chế điều chuẩn để kiểm soát hiện tượng quá khớp (Chen và Guestrin, 2016). Trong khi đó, LightGBM ưu tiên mở rộng lá tạo ra mức giảm hàm mất mát lớn nhất, đồng thời áp dụng các kỹ thuật tối ưu nhằm nâng cao hiệu quả huấn luyện trên dữ liệu có quy mô lớn (Ke và cộng sự, 2017).
Sự khác biệt về cơ chế học có thể dẫn đến hiệu năng phân loại khác nhau trên cùng một bộ dữ liệu. LightGBM được kỳ vọng có lợi thế khi xử lý dữ liệu lớn và cấu trúc phân lớp phức tạp. Tuy nhiên, kết quả thực tế vẫn phụ thuộc vào đặc điểm dữ liệu và cấu hình mô hình. Vì vậy, nghiên cứu tiếp tục kiểm định giả thuyết:
H2: LightGBM đạt hiệu năng phân loại cao hơn XGBoost trên bộ dữ liệu nghiên cứu.
2.3. Khả năng nhận diện các nhóm nợ thiểu số sau xử lý mất cân bằng
Dữ liệu nghiên cứu có sự chênh lệch đáng kể giữa nợ nhóm 1 và các nhóm nợ còn lại. Trong điều kiện này, mô hình có thể ưu tiên lớp chiếm đa số để tối đa hóa độ chính xác chung, qua đó làm giảm khả năng nhận diện các khoản vay thuộc nhóm nợ cần chú ý và nợ xấu (Lessmann và cộng sự, 2015).
Để xử lý tình trạng mất cân bằng dữ liệu, nghiên cứu áp dụng kỹ thuật SMOTE-ENN trên riêng tập huấn luyện. SMOTE tạo thêm các quan sát tổng hợp cho lớp thiểu số dựa trên các quan sát lân cận trong không gian đặc trưng (Chawla và cộng sự, 2002). ENN làm sạch dữ liệu bằng cách loại bỏ các quan sát có nhãn không phù hợp với phần lớn các điểm lân cận, qua đó cải thiện ranh giới giữa các lớp (Wilson, 1972). Sự kết hợp SMOTE và ENN nhằm vừa tăng cường thông tin cho lớp thiểu số, vừa giảm các quan sát gây nhiễu trong tập huấn luyện (Batista và cộng sự, 2004).
Do nghiên cứu không xây dựng mô hình đối chứng trên tập huấn luyện chưa được xử lý mất cân bằng, giả thuyết không nhằm xác định mức cải thiện riêng do SMOTE-ENN tạo ra. Việc kiểm định chỉ tập trung vào khả năng nhận diện các nhóm nợ có số lượng quan sát thấp trên tập kiểm thử độc lập. Trên cơ sở đó, nghiên cứu đề xuất giả thuyết:
H3: Sau khi áp dụng SMOTE-ENN trên tập huấn luyện, mô hình vẫn duy trì khả năng nhận diện các nhóm nợ thiểu số trên tập kiểm thử, thay vì chỉ dự báo nợ nhóm 1.
2.4. Dấu vết hành vi và mức độ ổn định thông tin khách hàng
Bên cạnh các thông tin về lịch sử tín dụng, nghĩa vụ trả nợ và đặc điểm nhân khẩu học, bộ dữ liệu của nghiên cứu còn bao gồm các biến phản ánh thời gian cư trú, thời điểm cập nhật giấy tờ định danh và thời điểm thay đổi số điện thoại. Các biến này thể hiện dấu vết hành vi và mức độ ổn định của thông tin khách hàng; qua đó có thể bổ sung tín hiệu cho quá trình phân loại rủi ro. Nhận định này phù hợp với hướng tiếp cận sử dụng dữ liệu hành vi trong mô hình rủi ro tín dụng của Khandani và cộng sự (2010).
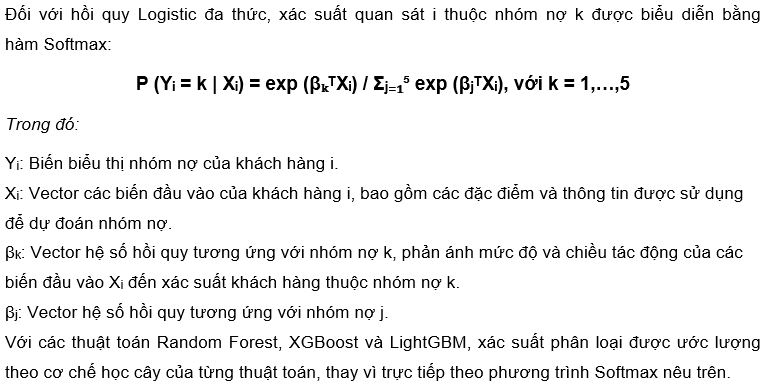
Nghiên cứu sử dụng phương pháp SHAP để lượng hóa mức đóng góp của từng biến vào kết quả dự báo của mô hình (Lundberg và Lee, 2017). Các giá trị SHAP được dùng để diễn giải cơ chế dự báo, không được hiểu là bằng chứng về quan hệ nhân quả. Trên cơ sở đó, nghiên cứu đề xuất giả thuyết:
H4: Các biến phản ánh dấu vết hành vi và mức độ ổn định thông tin khách hàng có mức đóng góp đáng kể vào kết quả phân loại rủi ro tín dụng, bên cạnh các biến nhân khẩu học, lịch sử tín dụng và nghĩa vụ tài chính.
2.5. Mô hình nghiên cứu
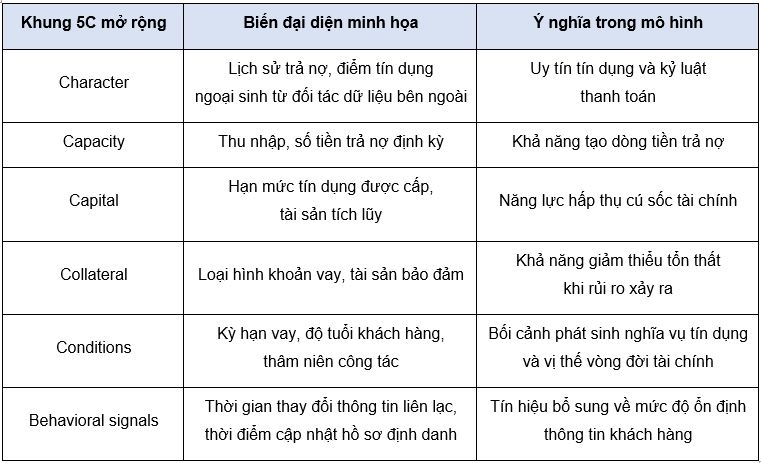
Khung nghiên cứu được xây dựng theo chuỗi logic gồm: Thu thập và chuẩn hóa dữ liệu khách hàng cá nhân; ánh xạ biến mục tiêu theo năm nhóm nợ; xử lý mất cân bằng lớp; huấn luyện và so sánh các thuật toán; sau đó giải thích kết quả bằng SHAP. Các biến đầu vào được liên hệ với khung 5C mở rộng (Character - tư cách người vay; Capacity - năng lực trả nợ; Capital - vốn tự có; Collateral - tài sản bảo đảm; Conditions - điều kiện kinh tế, thị trường và mục đích vay vốn; Behavioral Signals - tín hiệu hành vi), qua đó giúp ngân hàng đánh giá khách hàng một cách toàn diện trước khi quyết định cấp tín dụng.
 |
Bảng 1 trình bày các nhóm thông tin đầu vào trong khung nghiên cứu với các biến đại diện minh họa trong bộ dữ liệu ban đầu.
Bảng 1: Các nhóm thông tin đầu vào trong khung nghiên cứu
 |
| Nguồn: Tổng hợp của nhóm tác giả |
3. Phương pháp nghiên cứu
3.1. Dữ liệu nghiên cứu và quy trình xử lý
Nghiên cứu sử dụng bộ dữ liệu tín dụng khách hàng cá nhân tại các NHTM Việt Nam. Dữ liệu được tổ chức theo mô hình quan hệ (Relational Data Model), trong đó các bảng dữ liệu được liên kết thông qua mã định danh khách hàng đã được ẩn danh nhằm bảo đảm yêu cầu bảo mật thông tin. Bộ dữ liệu tích hợp bốn nhóm thông tin chính, gồm: (i) Dữ liệu hồ sơ tại thời điểm đề nghị cấp tín dụng với hơn 307.500 quan sát; (ii) Lịch sử tín dụng từ Trung tâm Thông tin tín dụng Quốc gia Việt Nam (CIC) bao gồm khoảng 1,7 triệu bản ghi cấp khoản vay và 27 triệu bản ghi theo tháng; (iii) Lịch sử khoản vay nội bộ với khoảng 1,6 triệu bản ghi; và (iv) Dữ liệu về thanh toán, số dư thẻ tín dụng và các khoản vay tiêu dùng với quy mô từ 10 đến 13,6 triệu bản ghi.
Để bảo đảm tính đồng nhất của mẫu nghiên cứu và phản ánh đặc điểm của phân khúc tín dụng bán lẻ trọng tâm, nghiên cứu lựa chọn các khoản vay có thời hạn từ 1 đến 2 năm để phân tích. Phân khúc này chiếm 55,68% tổng số khoản vay trong bộ dữ liệu, tương ứng 171.221 quan sát, đồng thời có quy mô đủ lớn để xây dựng và đánh giá các mô hình học máy.
3.2. Thiết kế biến mục tiêu đa lớp và xử lý mất cân bằng dữ liệu
Để phản ánh đầy đủ mức độ suy giảm chất lượng tín dụng, nghiên cứu xây dựng biến mục tiêu theo bài toán phân loại đa lớp. Cụ thể, số ngày quá hạn (Days Past Due - DPD) được ánh xạ thành năm nhóm nợ theo quy định tại Thông tư số 31/2024/TT-NHNN ngày 30/6/2024 của Thống đốc NHNN quy định về phân loại tài sản có trong hoạt động của NHTM, tổ chức tín dụng phi ngân hàng, chi nhánh ngân hàng nước ngoài, được sửa đổi, bổ sung bởi Thông tư số 37/2025/TT-NHNN ngày 31/10/2025. Theo đó, nhóm 1 gồm các khoản vay có DPD dưới 10 ngày; nhóm 2 từ 10 đến 90 ngày; nhóm 3 từ 91 đến 180 ngày; nhóm 4 từ 181 đến 360 ngày; và nhóm 5 trên 360 ngày.
Trong phân khúc khoản vay có thời hạn từ 1 đến 2 năm, nhóm 1 chiếm 84,99% (145.525 khoản vay) và nhóm 2 chiếm 5,49%, trong khi tổng tỉ trọng các khoản vay thuộc nhóm 3 đến nhóm 5 chỉ đạt 9,51%, lần lượt là 4,73%; 2,88% và 1,90%. Phân bố này cho thấy dữ liệu nghiên cứu có sự mất cân bằng đáng kể giữa nhóm đa số và các nhóm thiểu số. Để hạn chế ảnh hưởng của hiện tượng này đến quá trình huấn luyện, nghiên cứu áp dụng kỹ thuật SMOTE-ENN trên tập huấn luyện trước khi xây dựng các mô hình dự báo.
3.3. Quy trình thực nghiệm và các thuật toán học máy
Nghiên cứu được thực hiện theo quy trình chuẩn CRISP-DM (Chapman và cộng sự, 2000), bao gồm các bước từ chuẩn bị dữ liệu, xây dựng đặc trưng, huấn luyện đến đánh giá mô hình. Toàn bộ dữ liệu được phân chia theo phương pháp phân tầng (Stratified Split) với tỉ lệ 70/15/15 tương ứng cho tập huấn luyện, tập xác thực và tập kiểm thử độc lập. Trong đó, tập kiểm thử gồm 25.684 quan sát và chỉ được sử dụng để đánh giá hiệu năng cuối cùng của các mô hình.
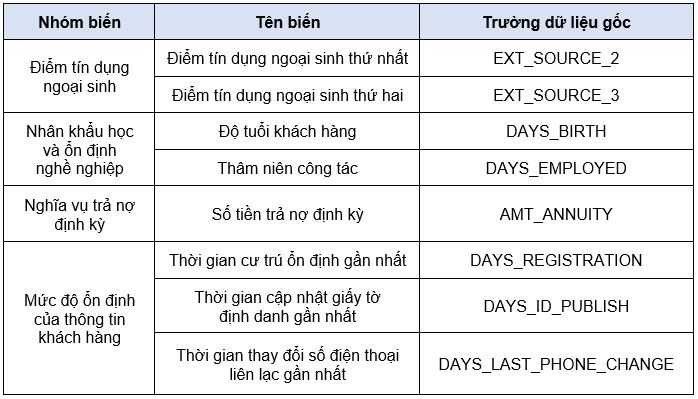
SMOTE-ENN được áp dụng riêng trên tập huấn luyện nhằm hạn chế nguy cơ rò rỉ thông tin sang tập xác thực và tập kiểm thử. Sau đó, nghiên cứu sử dụng kỹ thuật Recursive Feature Elimination (RFE) kết hợp với mô hình Random Forest để lựa chọn các biến đầu vào có mức độ đóng góp cao nhất cho quá trình phân loại. Kết quả lựa chọn giữ lại 8 biến đặc trưng, được trình bày tại Bảng 2.
Trên cơ sở tập dữ liệu đã được xử lý, nghiên cứu xây dựng và so sánh bốn mô hình gồm hồi quy Logistic đa thức, Random Forest, XGBoost và LightGBM theo chiến lược Champion-Challenger. Trong đó, hồi quy Logistic đa thức được sử dụng làm mô hình cơ sở để đối chiếu với các thuật toán học máy còn lại. Hiệu năng của các mô hình được đánh giá theo các chỉ tiêu trình bày tại mục 3.4.
Bảng 2: Danh mục 8 biến trọng yếu được lựa chọn cho mô hình
 |
| Nguồn: Tổng hợp của nhóm tác giả |
3.4. Thước đo hiệu năng và giải thích mô hình
Sau khi áp dụng kỹ thuật loại bỏ đặc trưng đệ quy (Recursive Feature Elimination - RFE) kết hợp với mô hình Random Forest, nghiên cứu lựa chọn tám biến có mức độ quan trọng cao nhất để xây dựng mô hình dự báo (Bảng 2).
Bốn thuật toán gồm hồi quy Logistic đa thức (Multinomial Logistic Regression), Random Forest, XGBoost và LightGBM được huấn luyện và đánh giá theo cách tiếp cận Champion-Challenger, trong đó hồi quy Logistic đa thức được sử dụng làm mô hình cơ sở để so sánh.
Hiệu năng của các mô hình được đánh giá thông qua Accuracy, Recall có trọng số (weighted Recall), F1-score có trọng số (weighted F1-score) và AUC (Area Under the ROC Curve - diện tích dưới đường cong ROC,một đường biểu diễn khả năng phân biệt của mô hình khi thay đổi ngưỡng phân loại) theo phương pháp One-versus-Rest (OvR). Trong đó, Accuracy phản ánh tỉ lệ dự báo đúng trên toàn bộ tập dữ liệu; Recall và F1-score có trọng số phản ánh hiệu năng tổng thể của mô hình trong điều kiện dữ liệu mất cân bằng; AUC theo từng nhóm nợ được sử dụng để đánh giá khả năng phân biệt giữa từng nhóm nợ với các nhóm còn lại.
Để tăng cường khả năng giải thích mô hình, nghiên cứu sử dụng kỹ thuật SHAP nhằm lượng hóa mức đóng góp của từng biến đầu vào đối với kết quả dự báo, từ đó hỗ trợ phân tích các yếu tố ảnh hưởng đến phân loại rủi ro tín dụng (Lundberg and Lee, 2017).
4. Kết quả nghiên cứu
4.1. Hiệu năng của các mô hình trên tập kiểm thử
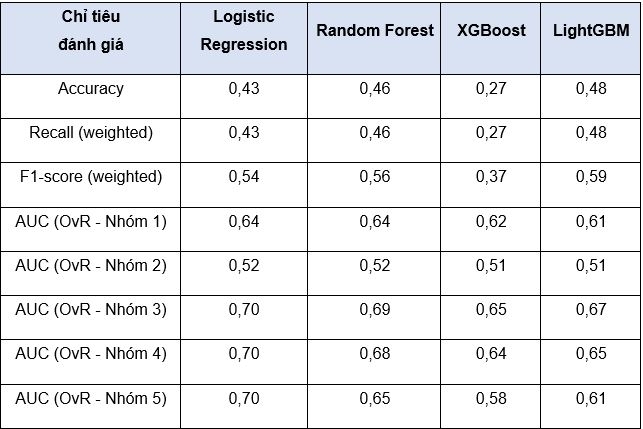
Kết quả đánh giá hiệu năng của bốn mô hình trên tập kiểm thử độc lập gồm 25.684 quan sát được trình bày tại Bảng 3. Accuracy phản ánh tỉ lệ dự báo đúng trên toàn bộ tập kiểm thử. Recall và F1-score được tính theo trung bình có trọng số (weighted average) nhằm phản ánh hiệu năng tổng thể của mô hình trong điều kiện dữ liệu mất cân bằng. Trong bài toán phân loại đa lớp một nhãn, Recall có trọng số có thể trùng với Accuracy do được tính trên cùng tập quan sát và có xét đến tỉ trọng của từng nhóm nợ. Vì vậy, việc hai chỉ tiêu này có cùng giá trị trong Bảng 3 là phù hợp với đặc điểm của dữ liệu và phương pháp đánh giá được sử dụng trong nghiên cứu. Đối với AUC, nghiên cứu sử dụng phương pháp One-versus-Rest (OvR) để đánh giá khả năng phân biệt của từng mô hình đối với từng nhóm nợ.
Bảng 3: Hiệu năng của các mô hình trên tập kiểm thử
 |
| Nguồn: Kết quả tính toán từ dữ liệu nghiên cứu |
Kết quả tại Bảng 3 cho thấy LightGBM đạt hiệu năng tổng thể cao nhất trong số bốn mô hình được so sánh, với Accuracy đạt 0,48, Recall (weighted) đạt 0,48 và F1-score (weighted) đạt 0,59. Random Forest xếp thứ hai với Accuracy đạt 0,46 và F1-score đạt 0,56; tiếp theo là hồi quy Logistic đa thức với Accuracy đạt 0,43 và F1-score đạt 0,54. XGBoost có hiệu năng thấp nhất trong điều kiện dữ liệu và cấu hình thực nghiệm của nghiên cứu. Kết quả này cho thấy LightGBM đạt sự cân bằng tốt hơn giữa độ chính xác và khả năng phân loại tổng thể trên bộ dữ liệu nghiên cứu.
Xét theo chỉ tiêu AUC, khả năng phân biệt giữa các nhóm nợ có sự khác biệt giữa các mô hình. Đối với nhóm 3, hồi quy Logistic đa thức đạt AUC bằng 0,70, cao hơn Random Forest (0,69), LightGBM (0,67) và XGBoost (0,65). Xu hướng tương tự cũng được ghi nhận ở nhóm 4, với AUC của Logistic đạt 0,70, Random Forest đạt 0,68, LightGBM đạt 0,65 và XGBoost đạt 0,64. Đối với nhóm 5, Logistic tiếp tục đạt AUC bằng 0,70, trong khi Random Forest, LightGBM và XGBoost lần lượt đạt 0,65, 0,61 và 0,58. Kết quả này cho thấy hồi quy Logistic có khả năng phân biệt tốt hơn đối với một số nhóm nợ rủi ro khi đánh giá trên nhiều ngưỡng xác suất.
Tuy nhiên, AUC phản ánh khả năng phân biệt của mô hình, trong khi Accuracy và F1-score phản ánh hiệu năng phân loại tại ngưỡng dự báo được lựa chọn. Vì vậy, việc lựa chọn mô hình không nên dựa trên một chỉ tiêu riêng lẻ. Trên bộ dữ liệu nghiên cứu, mặc dù hồi quy Logistic đạt AUC cao hơn ở một số nhóm nợ, LightGBM vẫn đạt Accuracy và F1-score có trọng số cao nhất, cho thấy mô hình này mang lại hiệu năng tổng thể tốt hơn trong bài toán phân loại năm nhóm nợ.
Kết quả kiểm định ủng hộ giả thuyết H2, theo đó LightGBM đạt hiệu năng tổng thể cao hơn XGBoost trên bộ dữ liệu nghiên cứu. Đối với giả thuyết H1, kết quả chỉ ủng hộ một phần, khi Random Forest và LightGBM đạt Accuracy và F1-score cao hơn hồi quy Logistic đa thức, trong khi XGBoost không vượt mô hình cơ sở. Điều này cho thấy hiệu quả của các thuật toán tổ hợp không chỉ phụ thuộc vào cơ chế học mà còn chịu ảnh hưởng của đặc điểm dữ liệu, chiến lược xử lý mất cân bằng và quá trình hiệu chỉnh siêu tham số.
4.2. Khả năng nhận diện các nhóm nợ thiểu số
Kết quả phân loại chi tiết của LightGBM cho thấy Recall đối với nhóm 1 đạt 0,53. Đối với các nhóm nợ thiểu số, Recall ở các nhóm 2, 3, 4 và 5 lần lượt đạt 0,13; 0,26; 0,16 và 0,11. Như vậy, mô hình không dự báo hoàn toàn về nhóm 1 mà vẫn nhận diện được một phần các khoản vay thuộc các nhóm nợ còn lại.
Nghiên cứu cho thấy mô hình vẫn duy trì khả năng nhận diện các nhóm nợ thiểu số sau khi SMOTE-ENN được áp dụng trên tập huấn luyện. Tuy nhiên, do chưa xây dựng mô hình đối chứng trên dữ liệu chưa xử lý mất cân bằng, nghiên cứu chưa đủ cơ sở để xác định mức cải thiện riêng do SMOTE-ENN tạo ra. Kết quả thực nghiệm ủng hộ giả thuyết H3 trong phạm vi hạn chế nêu trên.
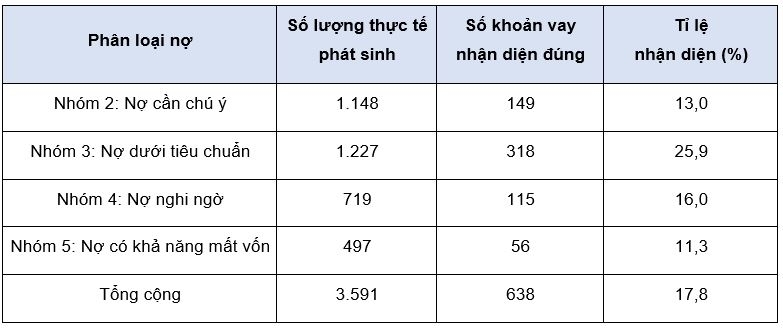
Khả năng nhận diện của LightGBM đối với các khoản vay thuộc nhóm 2 đến nhóm 5 được trình bày tại Bảng 4.
Bảng 4: Khả năng nhận diện của LightGBM đối với các nhóm nợ từ nhóm 2 đến nhóm 5
 |
| Nguồn: Kết quả tính toán từ dữ liệu nghiên cứu |
Bảng 4 cho thấy LightGBM nhận diện đúng 638 trong tổng số 3.591 khoản vay thực tế thuộc nhóm 2 đến nhóm 5, tương ứng 17,8%. Nhóm 3 có tỉ lệ nhận diện cao nhất, đạt 25,9%. Tỉ lệ này ở nhóm 4 là 16,0%, nhóm 2 là 13,0% và nhóm 5 là 11,3%. Kết quả cho thấy mô hình có khả năng bổ sung tín hiệu cảnh báo đối với một bộ phận khoản vay có dấu hiệu suy giảm chất lượng. Tuy nhiên, mức nhận diện còn thấp, đặc biệt đối với nhóm 2 và nhóm 5. Vì vậy, mô hình chỉ phù hợp với vai trò hỗ trợ sàng lọc và cảnh báo, chưa đủ cơ sở để sử dụng như công cụ ra quyết định độc lập.
4.3. Giải thích kết quả dự báo bằng SHAP
Phân tích SHAP được thực hiện đối với kết quả dự báo nhóm 5 nhằm xác định những biến có mức đóng góp lớn vào quyết định phân loại của mô hình. Tám biến được lựa chọn có thể được khái quát thành bốn nhóm thông tin.
Thứ nhất, hai điểm đánh giá tín dụng từ nguồn dữ liệu bên ngoài, gồm EXT_SOURCE_2 và EXT_SOURCE_3, nằm trong nhóm biến có mức đóng góp lớn nhất. Trên biểu đồ SHAP, các giá trị điểm thấp thường xuất hiện ở vùng SHAP dương, cho thấy các quan sát này có xu hướng có mức đóng góp dương vào kết quả dự báo nhóm 5.
Thứ hai, độ tuổi và thâm niên công tác phản ánh đặc điểm vòng đời tài chính và mức độ ổn định nghề nghiệp của khách hàng. Trong bộ dữ liệu nghiên cứu, các giá trị thể hiện khách hàng trẻ hơn hoặc có thời gian công tác ngắn hơn thường gắn với mức đóng góp dương vào dự báo nhóm 5. Kết quả này chỉ phản ánh cách mô hình sử dụng các biến trong bộ dữ liệu, không chứng minh rằng độ tuổi trẻ hoặc thâm niên ngắn trực tiếp gây ra rủi ro tín dụng.
Thứ ba, số tiền trả nợ định kỳ phản ánh quy mô nghĩa vụ tài chính của khách hàng. Các giá trị cao của biến này thường có mức đóng góp dương vào kết quả dự báo rủi ro trong nhiều quan sát. Tuy nhiên, do bộ dữ liệu không trình bày trực tiếp tỉ lệ nghĩa vụ trả nợ trên thu nhập, kết quả không nên được diễn giải thành mức độ quá tải tài chính nếu chưa có thêm thông tin về thu nhập khách hàng.
Thứ tư, các biến về thời gian đăng ký thông tin, thời điểm cập nhật giấy tờ định danh và thời gian thay đổi số điện thoại cũng nằm trong nhóm biến quan trọng. Các biến này phản ánh mức độ ổn định của thông tin khách hàng hơn là hành vi thanh toán trực tiếp. Nhóm thông tin này bổ sung giá trị dự báo bên cạnh các biến về tín dụng, nhân khẩu học và nghĩa vụ tài chính. Tuy nhiên, SHAP chỉ lượng hóa mức đóng góp của biến vào kết quả dự báo và không xác lập quan hệ nhân quả giữa các biến đầu vào và rủi ro tín dụng. Kết quả thực nghiệm ủng hộ giả thuyết H4 trong phạm vi bộ dữ liệu nghiên cứu, với lưu ý nêu trên về giới hạn diễn giải của SHAP.
5. Kết luận và khuyến nghị đối với các NHTM
Kết quả nghiên cứu cho thấy LightGBM đạt hiệu năng phân loại tổng thể cao nhất trong số bốn mô hình được so sánh, trong khi hồi quy Logistic đa thức duy trì năng lực phân biệt cao hơn theo AUC. Khả năng nhận diện các khoản vay thuộc nhóm nợ rủi ro của tất cả các mô hình vẫn còn hạn chế, do đó mô hình được định vị như một lớp cảnh báo bổ sung cho quy trình thẩm định hiện hữu thay vì công cụ ra quyết định độc lập. Thuật toán Random Forest cho kết quả tương đối tích cực, trong khi hồi quy Logistic đa thức vẫn duy trì khả năng phân loại cạnh tranh trên một số chỉ tiêu. Phân tích SHAP ghi nhận mức đóng góp đáng kể của các điểm đánh giá tín dụng từ nguồn dữ liệu bên ngoài, độ tuổi, thâm niên công tác, nghĩa vụ trả nợ định kỳ và các biến phản ánh mức độ ổn định của thông tin khách hàng. Các phát hiện này cho thấy học máy có thể bổ sung tín hiệu cho hoạt động phân loại, sàng lọc và cảnh báo sớm rủi ro tín dụng, nhưng chưa phù hợp để thay thế quy trình thẩm định và quyết định cấp tín dụng của ngân hàng.
Từ kết quả thực nghiệm, nghiên cứu đề xuất một số khuyến nghị đối với các NHTM Việt Nam như sau:
Thứ nhất, tích hợp học máy như một công cụ hỗ trợ trong quy trình thẩm định tín dụng. Kết quả dự báo theo từng nhóm nợ có thể được sử dụng để phân luồng hồ sơ. Các khoản vay có tín hiệu rủi ro thấp có thể được xem xét theo luồng xử lý nhanh với cơ chế kiểm soát phù hợp; các hồ sơ có kết quả chưa rõ ràng cần được chuyển sang thẩm định bổ sung; còn các khoản vay có tín hiệu rủi ro cao cần được cảnh báo và xem xét ở cấp phê duyệt tương ứng. Mô hình không thay thế trách nhiệm đánh giá của cán bộ tín dụng hoặc thẩm quyền phê duyệt theo chính sách nội bộ của từng ngân hàng.
Thứ hai, tăng cường cảnh báo sớm trên cơ sở kết hợp dữ liệu hồ sơ và thông tin phát sinh trong quá trình quan hệ tín dụng. Ngân hàng có thể theo dõi định kỳ sự thay đổi của nghĩa vụ trả nợ, lịch sử thanh toán, thông tin định danh và các chỉ dấu phản ánh mức độ ổn định của khách hàng. Tuy nhiên, từng tín hiệu cần được kiểm định trên dữ liệu nội bộ, đánh giá tính ổn định theo thời gian và xem xét nguy cơ phát sinh cảnh báo sai trước khi đưa vào vận hành.
Thứ ba, kết quả phân loại có thể được sử dụng như một nguồn thông tin bổ sung cho quản trị danh mục và xây dựng chính sách tín dụng theo mức độ rủi ro. Kết quả dự báo của mô hình có thể hỗ trợ ngân hàng trong việc phân tầng khách hàng, theo dõi chất lượng danh mục và xác định các nhóm khoản vay cần tăng cường giám sát. Tuy nhiên, kết quả phân loại của nghiên cứu chưa thể được sử dụng trực tiếp như xác suất vỡ nợ (Probability of Default - PD) phục vụ mô hình tổn thất tín dụng kỳ vọng theo IFRS 9. Để đáp ứng yêu cầu này, ngân hàng cần xây dựng thêm các mô hình chuyên biệt nhằm ước lượng xác suất vỡ nợ, tỉ trọng tổn thất khi vỡ nợ (Loss Given Default - LGD) và dư nợ tại thời điểm vỡ nợ (Exposure at Default - EAD).
Thứ tư, thiết lập cơ chế quản trị vòng đời mô hình. Trước khi triển khai trên diện rộng, mô hình cần được kiểm định độc lập, thử nghiệm trong môi trường vận hành có kiểm soát và đánh giá theo từng phân khúc khách hàng. Trong quá trình sử dụng, ngân hàng cần theo dõi sự thay đổi của dữ liệu, mức suy giảm hiệu năng, sai lệch giữa các nhóm khách hàng và mức độ phù hợp của ngưỡng phân loại. Cơ chế Champion - Challenger (mô hình nhà vô địch - người thách đấu, là phương pháp thử nghiệm và quản lý, trong đó một chiến lược, mô hình hoặc quy trình đang hoạt động hiệu quả nhất (Champion) được đem ra so sánh trực tiếp với một hoặc nhiều phiên bản mới cải tiến (Challenger) trong cùng một điều kiện thực tế) có thể được duy trì để so sánh mô hình đang vận hành với các mô hình thay thế trước khi quyết định nâng cấp.
Nghiên cứu còn một số hạn chế. Dữ liệu được thu thập từ một số NHTM nên khả năng khái quát kết quả cho toàn hệ thống còn giới hạn. Mô hình chưa tích hợp các biến kinh tế vĩ mô, chưa mở rộng sang LGD và EAD, đồng thời chưa có mô hình đối chứng để lượng hóa riêng tác động của SMOTE-ENN. Bên cạnh đó, kết quả mới được kiểm định trên dữ liệu lịch sử và chưa được thử nghiệm trực tiếp trong môi trường vận hành. Các nghiên cứu tiếp theo có thể mở rộng mẫu sang nhiều ngân hàng, bổ sung dữ liệu vĩ mô và dữ liệu thay thế, thực hiện kiểm định ngoài thời gian, đánh giá mức độ công bằng giữa các nhóm khách hàng và xây dựng cơ chế giám sát sau triển khai.
Nhìn chung, học máy có tiềm năng bổ sung năng lực phân loại và cảnh báo rủi ro tín dụng khách hàng cá nhân cho các NHTM. Giá trị của mô hình phụ thuộc không chỉ vào thuật toán mà còn vào chất lượng dữ liệu, khả năng giải thích, cơ chế kiểm định độc lập và sự giám sát của con người trong toàn bộ quá trình ra quyết định.
* Bài viết được thực hiện trong khuôn khổ đề tài khoa học công nghệ cấp Bộ: "Ứng dụng thuật toán máy tính xếp hạng tín dụng khách hàng cá nhân tại các NHTM Việt Nam" - Mã số: B2025-KSA-10.
Tài liệu tham khảo
1. Baesens, B., Van Gestel, T., Viaene, S., Stepanova, M., Suykens, J. and Vanthienen, J. (2003), “Benchmarking state-of-the-art classification algorithms for credit scoring”, Journal of the Operational Research Society, 54(6), 627-635.
2. Batista, G. E. A. P. A., Prati, R. C. and Monard, M. C. (2004), “A study of the behavior of several methods for balancing machine learning training data”, ACM SIGKDD Explorations Newsletter, 6(1), 20-29.
3. Breiman, L. (2001), “Random forests”, Machine Learning, 45(1), 5-32.
4. Chapman, P., Clinton, J., Kerber, R., Khabaza, T., Reinartz, T., Shearer, C. and Wirth, R. (2000), CRISP-DM 1.0: Step-by-step data mining guide, SPSS Inc., Chicago.
5. Chawla, N. V., Bowyer, K. W., Hall, L. O. and Kegelmeyer, W. P. (2002), “SMOTE: Synthetic minority over-sampling technique”, Journal of Artificial Intelligence Research, 16, 321-357.
6. Chen, T. and Guestrin, C. (2016), “XGBoost: A scalable tree boosting system”, Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, 785-794.
7. Crook, J. N., Edelman, D. B. and Thomas, L. C. (2007), “Recent developments in consumer credit risk assessment”, European Journal of Operational Research, 183(3), 1447-1465.
8. Davis, J. and Goadrich, M. (2006), “The relationship between precision-recall and ROC curves”, Proceedings of the 23rd International Conference on Machine Learning, 233-240.
9. Hand, D. J. (2009), “Measuring classifier performance: A coherent alternative to the area under the ROC curve”, Machine Learning, 77(1), 103-123.
10. Hand, D. J. and Henley, W. E. (1997), “Statistical classification methods in consumer credit scoring: A review”, Journal of the Royal Statistical Society: Series A (Statistics in Society), 160(3), 523-541.
11. Huỳnh Thị Cẩm Hà và cộng sự (2017), “Ứng dụng mô hình cây phân lớp trong dự báo kiệt quệ tài chính của các công ty niêm yết tại Việt Nam”, Tạp chí Phát triển Kinh tế, 28(11), trang 46-64.
12. IFRS Foundation (2014), IFRS 9 Financial Instruments, IFRS Foundation, London.
13. Ke, G., Meng, Q., Finley, T., Wang, T., Chen, W., Ma, W., Ye, Q. and Liu, T. Y. (2017), “LightGBM: A highly efficient gradient boosting decision tree”, Advances in Neural Information Processing Systems, 30, 3146-3154.
14. Khandani, A. E., Kim, A. J. and Lo, A. W. (2010), “Consumer credit-risk models via machine-learning algorithms”, Journal of Banking & Finance, 34(11), 2767-2787.
15. Leo, M., Sharma, S. and Maddulety, K. (2019), “Machine learning in banking risk management: A literature review”, Risks, 7(1), 29.
16. Lessmann, S., Baesens, B., Seow, H. V. and Thomas, L. C. (2015), “Benchmarking state-of-the-art classification algorithms for credit scoring: An update of research”, European Journal of Operational Research, 247(1), 124-136.
17. Lundberg, S. M. and Lee, S. I. (2017), “A unified approach to interpreting model predictions”, Advances in Neural Information Processing Systems, 30, 4765-4774.
18. Mitchell, T. M. (1997), Machine Learning, McGraw-Hill, New York.
19. Ngân hàng Nhà nước Việt Nam (2024), Thông tư số 31/2024/TT-NHNN ngày 30/6/2024 quy định về phân loại tài sản có trong hoạt động của ngân hàng thương mại, tổ chức tín dụng phi ngân hàng, chi nhánh ngân hàng nước ngoài.
20. Ngân hàng Nhà nước Việt Nam (2025), Thông tư số 37/2025/TT-NHNN ngày 31/10/2025 sửa đổi, bổ sung một số điều của Thông tư số 31/2024/TT-NHNN ngày 30/6/2024 quy định về phân loại tài sản có trong hoạt động của ngân hàng thương mại, tổ chức tín dụng phi ngân hàng, chi nhánh ngân hàng nước ngoài.
21. Saito, T. and Rehmsmeier, M. (2015), “The precision-recall plot is more informative than the ROC plot when evaluating binary classifiers on imbalanced datasets”, PLoS ONE, 10(3), e0118432.
22. Thomas, L. C., Edelman, D. B. and Crook, J. N. (2002), Credit Scoring and Its Applications, Society for Industrial and Applied Mathematics, Philadelphia.
23. Trương Thị Thùy và Lê Hải Trung (2023), “Ứng dụng phương pháp học máy trong dự báo rủi ro phá sản của các doanh nghiệp Việt Nam”, Tạp chí Kinh tế và Phát triển, số 310, trang 44-53.
24. Wilson, D. L. (1972), “Asymptotic properties of nearest neighbor rules using edited data”, IEEE Transactions on Systems, Man, and Cybernetics, 2(3), 408-421.
Đường dẫn bài viết: https://thoibaonganhang.vn/ung-dung-hoc-may-trong-phan-loai-rui-ro-tin-dung-khach-hang-ca-nhan-tai-cac-ngan-hang-thuong-mai-viet-nam-187826.htmlIn bài viết
Cấm sao chép dưới mọi hình thức nếu không có sự chấp thuận bằng văn bản. Copyright © 2026 https://thoibaonganhang.vn/ All right reserved.